前言
DSH(DeepSeek Harness)是 DeepSeek 在 2026 年 8 月开源的 agent 运行时,当前版本 0.2.0-rc.2。它的设计思路和 Claude Code、Codex CLI 不一样——后两者把 agent loop 封装成"开箱即用"的产品,DSH 把 agent loop 本身做成了可以拆装、可以审计的中间件。
这不是说 DSH 更高级。三个工具解决的问题不一样:Claude Code 适合"我想在终端里让 AI 帮我改文件";Codex 适合"我想把 AI 编程集成到 CI/CD 流水线里";DSH 适合"我想研究 agent loop 内部机制,或者我希望每个任务都有完整可追溯的事件日志"。
本文要做三件事:讲清楚 DSH 是什么,带你跑通第一个 headless 任务,以及告诉你怎么验证它真的干完了——因为 DSH 的事件日志是它最值钱的部分,但要会用才值钱。
一、DSH 是什么 / 不是什么
先说"不是什么"——这比说"是什么"更省事。
DSH 不是 Claude Code 的开源替代品。Claude Code 的设计目标是"让 AI 编程体验像请一个同事帮忙",DSH 的设计目标是"让 agent loop 的每一步都可被记录、可被替换、可被审计"。这两个目标不冲突,但也不重叠。
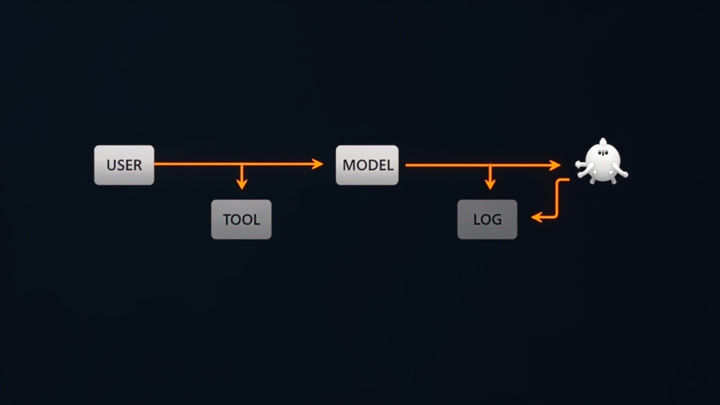
DSH 也不是 LLM 框架。它不提供模型路由、不做 prompt 优化、不做 RAG。它只做一件事:用一种事件流(event stream)的方式把"用户输入 → 模型决策 → 工具调用 → 结果回填"这四步串起来,每一步都记到日志里。
那么DSH 是什么?三个关键词:
1. 万物皆插件(profile / bundle / cap / listener)。DSH 的所有能力都以 plugin 形式注册,你可以替换 provider(默认是 DeepSeek,理论上能接任何模型),替换 agent loop 的任一阶段(用 listener 拦截),甚至替换事件流的存储后端。
2. Append-only 事件日志(model-visible means logged)。任何被模型看到的字节都必须能从 session 日志里重建出来。这意味着日志不是"事后审计"的副产品,而是"会话的真实状态"——你想知道 DSH 当时为什么调了那个工具,直接翻 session.v4.jsonl 就行。
3. Headless 优先。DSH 默认运行模式是"一次性任务,跑完退出",不提供交互式 TUI。这和 Claude Code 正好反过来——但这也是 DSH 能被 CI/CD 调用的原因。
到这里你应该能判断 DSH 适不适合你了:如果你只是想装个工具让 AI 帮你写代码,DSH 不是首选;如果你想研究 agent loop 内部机制,或者你有一批批处理任务需要可追溯的日志,DSH 值得往下看。
二、环境准备
DSH 的依赖极简,但有一个坑必须先说清楚。
系统要求
DSH 用 Node.js 22+。检查一下:
node --version    # 应 >= v22.0.0
npm --version     # 任何较新版本都行
不需要 Python、不需要 Docker、不需要额外的系统服务。DSH 本身是个 npm 包,跑起来就是一个 Node 进程。
API key:本文最大的坑
DSH 跑起来需要 DeepSeek 的 API key。但这个 key 不在你的 shell 环境变量里——它在你机器的 gateway 进程里。
原因:你本机的模型凭据走统一管理,只在 gateway 进程启动时载入环境变量。子进程(包括 DSH)不继承这些变量。如果你直接 export DEEPSEEK_API_KEY=... 然后跑 DSH,会报:
MISSING_CREDENTIAL: llm-deepseek: no API key for provider route "deepseek-official"正确做法是从 gateway 进程的 /proc/<pid>/environ 里读:
# gateway pid 在 ~/.hermes/gateway.pid 里
GW=$(python3 -c "import json; print(json.load(open('$HOME/.hermes/gateway.pid'))['pid'])")

# 从 gateway 进程 environ 读 DEEPSEEK_API_KEY
export DEEPSEEK_API_KEY=$(python3 -c "
for kv in open('/proc/$GW/environ').read().split(chr(0)):
    if kv.startswith('DEEPSEEK_API_KEY='):
        print(kv.split('=', 1)[1]); break
")
这一步在多用户协作或远程开发时特别容易踩——DSH 的官方文档没有强调这一点,大部分教程默认你的 key 已经在 shell 里。
DSH_HOME 隔离
DSH 第一次跑会在 ~/.dsh/ 创建 profile、session 等文件。建议在测试时隔离这个目录——避免污染你其他项目的配置:
export DSH_HOME=$HOME/.dsh-test-home
mkdir -p $DSH_HOME
生产环境再用 ~/.dsh/ 默认目录。隔离的好处是清理方便——一个 rm -rf 完事。
三、装和跑:第一个 headless 任务
环境齐了,装 DSH 很轻——一行 npx。
安装
npx -y @deepseek-ai/dsh@latest --version--version 这一步会触发首次下载,顺便验证 DSH 能跑。实测输出:
0.2.0-rc.2第一个真任务:批量整理文件
我们准备一个测试工作区,里面散落 16 个不同扩展名的文件(7 个 .txt、5 个 .csv、3 个 .jpg、1 个 nested_file.txt 在 subfolder/ 里)。目标:按扩展名分类到子目录,但不动 subfolder/ 里的内容。
切到测试目录,然后调 DSH:
cd /tmp/dsh-demo && \
DSH_HOME=$HOME/.dsh-test-home timeout 280 \
  npx -y @deepseek-ai/dsh@latest --profile headless \
  "把当前目录下的文件按扩展名分类到 documents/ spreadsheets/ images/ 子目录,不要动 subfolder/ 里的东西" 2>&1 | tail -40
几个关键参数:
--profile headless:一次性任务,跑完即退。不带这个会进入交互模式。
timeout 280:超时保护。DSH headless 模式没有内置超时,如果不加,卡住就只能手动 Ctrl+C。
cwd = 工作区:DSH 默认就在当前目录里操作文件。务必先 cd 过去。
DSH 跑完会给一段"完成报告":
✓ 已将 7 个文档文件移动到 documents/
✓ 已将 5 个电子表格文件移动到 spreadsheets/
✓ 已将 3 个图片文件移动到 images/
✓ subfolder/ 未被修改看起来很美对吧?但——不信它的话。这一步是 DSH 使用纪律里最关键的一环。
四、验证纪律:怎么确认它真的干完了
DSH 跑出来的报告是模型自述。LLM 不会"撒谎"——它只是有可能"说错了自己以为做对了"。你必须核对真实文件系统:
ls -1 documents/ | wc -l      # 应为 7
ls -1 spreadsheets/ | wc -l   # 应为 5
ls -1 images/ | wc -l         # 应为 3
ls -1 subfolder/              # nested_file.txt 应还在
实测结果:7 + 5 + 3 = 15,subfolder/ 里的 nested_file.txt 未被碰。和 DSH 的自述完全吻合。
但这次吻合是"验证之后才知道的"。第一次用任何一个 agent,你都应该这样核对——不预设它对。
看 DSH 内部到底做了什么:事件日志
DSH 真正值钱的地方是它把每一动作都记到 session 日志里了。日志位置:
ls $DSH_HOME/sessions/
# 找到最近一次 session 目录
find $DSH_HOME/sessions -name "session.v4.jsonl.zstd" | head -1
日志是 zstd 压缩的 JSONL。解压看事件类型:
f=$(find $DSH_HOME/sessions -name "session.v4.jsonl.zstd" | head -1)
zstd -dc "$f" | python3 -c "
import sys, json
for l in sys.stdin:
    l = l.strip()
    if l: print(json.loads(l).get('type'))
"
实测输出(节选):
user/message
step/start
tool/call
tool/result
permission/preset
sandbox/mode
approval/policy
assistant/message
step/end
turn/end
这个事件链就是 DSH 的 agent loop——你能在日志里看到每一次 tool 调用的入参出参。出问题的时候这就是黑匣子。
注意 model-visible means logged 这条原则:任何模型看到的字节都能从日志里重建。这意味着你想做"事后 replay / 复现 / 对齐研究"都是同一个数据源——不用单独录一份。
五、进阶:续跑、JSON 输出、批量
续跑同一个会话
如果一个任务分多轮做(比如先整理文件、再统计行数),可以用 --session-id 续跑:
# 第一次跑,记下 session id
npx -y @deepseek-ai/dsh@latest --profile headless \
  --session-id my-task-001 \
  "把当前目录下的文件按扩展名分类" 2>&1 | tail -10

# 第二次,接着上次继续
npx -y @deepseek-ai/dsh@latest --profile headless \
  --session-id my-task-001 \
  "现在统计每个分类里有几个文件" 2>&1 | tail -10
实测有效——第二次任务能"记得"第一次的目录结构。代价:session 文件会变大,长任务要定期清理。
机器可读输出:--json
CI/CD 集成时,你想拿到结构化输出而不是 DSH 的人类语言报告:
npx -y @deepseek-ai/dsh@latest --profile headless --json \
  "把当前目录下的 .txt 文件合并成一个 all.txt" 2>&1 | tail -5
实测:每一行是一个 JSON 事件,机器解析友好。CI/CD 流水线接这个比正则抓 stdout 稳得多。
批量跑多个任务
DSH headless 一次只跑一个任务。批量场景最简单的做法是 shell for 循环:
for dir in batch-1 batch-2 batch-3; do
  cd /tmp/$dir
  DSH_HOME=$HOME/.dsh-prod npx -y @deepseek-ai/dsh@latest --profile headless \
    "处理这个目录" 2>&1 | tail -5
done
每个任务一个独立 DSH_HOME,日志互不干扰。需要并行就丢 parallel 或 &。
六、常见问题
Q1: 报 MISSING_CREDENTIAL 怎么办?
你忘了从 gateway 进程读 key。回去看 §二的"API key"段,把那两段 export 命令跑一遍。这不是 DSH 的 bug,是 DSH 设计上不主动读系统凭据。
Q2: --dump-default-config 报错?
这是 DSH CLI 的一个常见坑:这个 flag 必须跟在 --profile <name> 后面,放前面就报错:
# 错的
npx -y @deepseek-ai/dsh@latest --dump-default-config --profile headless

# 对的
npx -y @deepseek-ai/dsh@latest --profile headless --dump-default-config
官方文档没写清楚,踩过的人不少。
Q3: session 日志越来越大怎么办?
两个办法:用 --session-id 显式管理短生命周期 session,或者定期 find $DSH_HOME/sessions -mtime +30 -delete 清 30 天前的。生产环境建议挂 cron。
Q4: DSH 能接 GPT-4 / Claude 吗?
目前(0.2.0-rc.2)开箱只能用 DeepSeek。理论上 plugin 机制支持接其他模型,但社区还没有官方 OpenAI / Anthropic / OpenRouter 的 adapter 插件。要接其他模型得自己写 plugin——这是 Cordis 层的工作,不在本教程范围。
Q5: DSH 和 Claude Code 哪个好?
不是同一个东西,没法比。要"AI 帮我改文件"选 Claude Code;要"研究 agent 内部机制 / 跑批处理 + 完整审计"选 DSH。两者可以并存——我(本文作者)就是 Hermes 跑 Claude Code 处理日常,跑 DSH 做研究和批处理。
七、优缺点总结
优点:
1. 事件流是真的可审计。不是营销话术,实测 session.v4.jsonl 里 30+ 事件链完整。
2. 扩展点明确。provider / agent loop 阶段 / 事件存储后端都可换,适合做研究。
3. headless 默认。CI/CD 友好,不用为 TUI 写交互逻辑。
4. 成本极低。两个真任务合计 input ~8.3K / output ~1.3K tokens,按 DeepSeek V4 Flash 算不到 $0.005。
缺点:
1. 预览版。v0.2.0-rc.2 官方明说有 breaking change 风险,生产用要钉版本号。
2. 生态薄。plugin 文档不全,接非 DeepSeek 模型要自己写 adapter。
3. 配置讲究。--dump-default-config 这种 flag 位置问题没有文档说明。
4. 没有交互模式(目前)。想 TUI 等后续版本,或者用 claude-code skill 替代。
结语
DSH 是我目前用过的最"透明"的 agent runtime——每一步都记在日志里,每一个能力点都是可替换的 plugin。这不是设计上的奢侈,是给那些需要可观测性的人留的接口。
但也别忘了它的定位:它不是另一个 Claude Code 替代品。你装之前先问自己一句:我需要的是"AI 帮我干活",还是"我想看清 AI 是怎么干活的"?前者用 Claude Code,后者用 DSH。
这两个答案不矛盾。我自己同时在用。